
一条公链为什么会停?从 Cosmos 停摆 25 小时,真正理解区块链共识
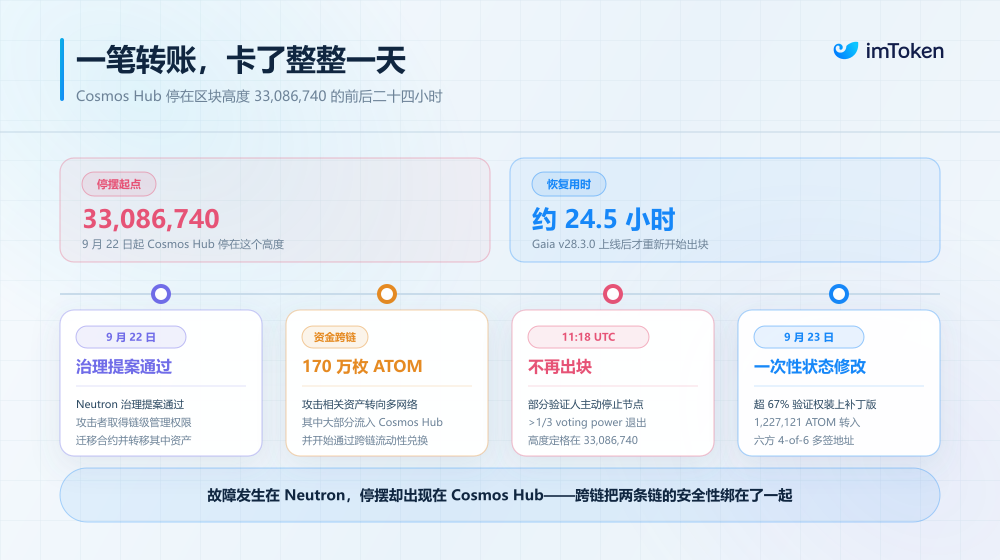
9 月 22 日晚,一名用户发出了一笔 ATOM 转账。
一夜过去,交易依然停留在「等待确认」。
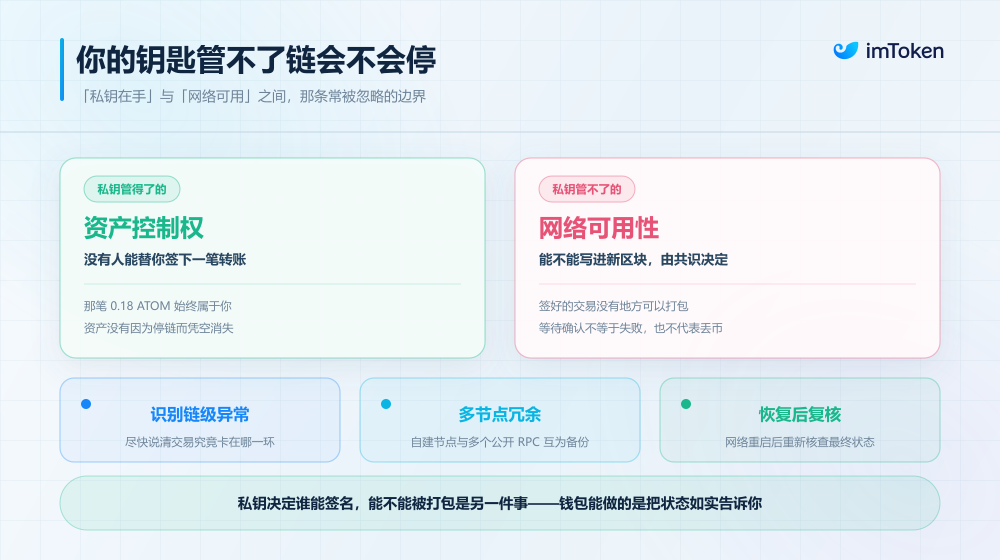
私钥没有丢,钱包也没有出现签名异常,第二天再次检查,多个公开 RPC 都显示 Cosmos Hub 停在了区块高度 33,086,740。
没有新的区块产生,自然也就没有任何地方能够把这笔交易打包进去。
直到大约一天之后 Cosmos Hub 恢复出块,这笔此前一直处于等待状态的 ATOM 转账才最终成功。
对于普通用户来说,这可能是理解区块链共识最直观的一堂课。
我们习惯说「没有任何中心机构可以关掉一条公链」,但现实显然要复杂得多,一条足够去中心化的区块链,确实通常不存在服务器机房里的那个「关机按钮」,但它仍然可能停止。
这一次 Cosmos Hub 的暂停,恰好把这套平时藏在底层的机制,完整地暴露到了普通用户面前。
一、Cosmos 为什么突然「停止出块」?
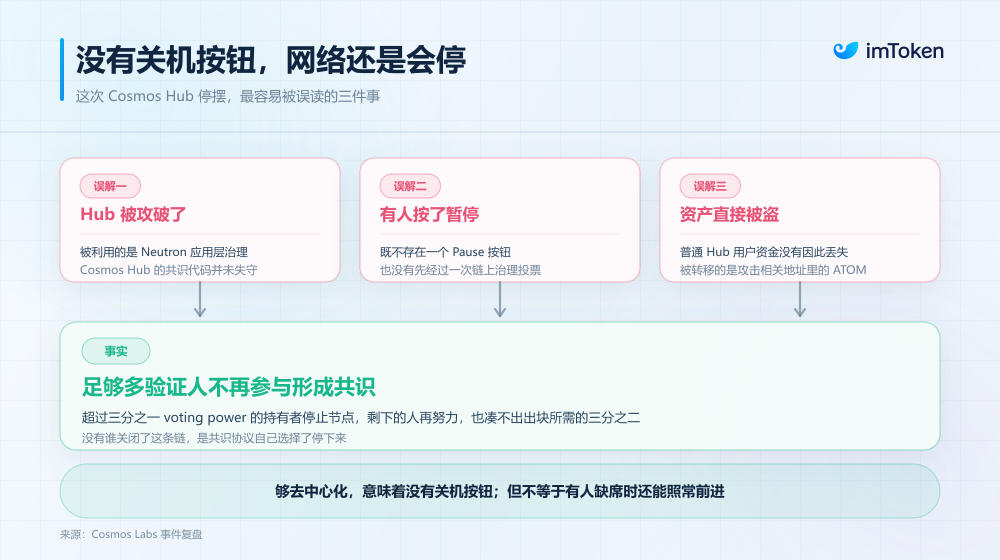
首先需要把一个容易混淆的问题说清楚,本次被直接攻击的,并不是 Cosmos Hub。
事件最早发生在 Neutron。
9 月 22 日,一项名为「AIATO: AI Agent Takeover」的 Neutron 治理提案获得通过,攻击者钻了链级治理权限的空子,利用 wasmd 框架原生提供的特权指令,把 Astroport、Drop 等应用的合约管理员改成了攻击者控制的地址。
这并不是我们通常理解的那种「代码漏洞」或「协议缺陷」。
可以简单理解为,应用本身有自己的「门锁」,但 Neutron 的链级治理手里还握着一把权限更高的「总钥匙」,而当攻击者控制了治理结果,也就等于拿到了这把钥匙,可以重新指定管理员、迁移合约,进一步转移其中的资产。
而真正让 Cosmos Hub 被卷进来的,是随后发生的跨链资金转移。
Cosmos Labs 复盘显示,在 Neutron 停止运行前,攻击者已把部分资产转向多个网络,其中大约 170 万枚 ATOM 被转入 Cosmos Hub,并开始通过跨链流动性进行兑换。
也就是说,Cosmos Hub 本身没有遭到直接攻击,普通 Hub 用户资金也没有因为 Neutron 漏洞直接被盗。
但攻击所得的 ATOM 已经进入了 Hub,为了阻止剩余 ATOM 继续流出,一部分 Cosmos Hub 验证人开始停止节点运行。
到 9 月 22 日 19:18 左右(SGT),停止运行的验证人已经代表超过三分之一的总 voting power,Cosmos Hub 因此无法继续形成新区块,最终停在 33,086,740。
这一步非常关键。
它意味着 Cosmos Hub 并不存在某家公司可以直接点击的「Pause」按钮,也没有先经过一次链上治理投票,真正让网络停下来的,是足够多验证人不再参与形成共识。
但更值得注意的,其实是后面的恢复过程。
停链大约 4 个小时后,验证者收到了一份完整的恢复方案:针对停链高度执行一次性的状态修改,把攻击者地址中剩余的 ATOM 转入由社区验证者共同管理的多签地址。
随后 Cosmos Labs 根据验证者已经达成的方案制作 Gaia v28.3.0 补丁,对其进行测试,并分发给验证者。
这版 Gaia 会在指定恢复高度执行一次性的状态变化,把攻击者地址中的 1,227,121 ATOM 转入由 Nansen、Keplr、Enigma、Silknodes、Kiln 和 Polkachu 六方组成的 4-of-6 多签地址。
到 9 月 23 日凌晨,确认安装 v28.3.0 的验证者已经超过总 voting power 的 67%,因此当天 12:00 UTC,Cosmos Hub 协调重启,约 6 分钟后,这次一次性状态修改在区块高度 33,086,741 执行,网络恢复正常出块。
说到底,Cosmos 停止出块到恢复运行的整个过程中,是验证者先让网络失去 Liveness,再由超过三分之二 voting power 接受一套新的状态转换规则,最终让这套规则成为恢复后的 canonical state。
到这里,一个看似简单的问题也就出现了:既然是一条去中心化公链,为什么超三分之一的验证权就能让它停下来,而恢复网络,又需要足够多验证者共同接受并运行同一套软件?
答案,其实就藏在「共识」两个字里。
二、所谓共识,本就不是「永远不会停」
区块链最容易被误解的一件事,就是把「去中心化」和「永不宕机」画上等号。
实际上,共识机制真正解决的问题,是在没有一个中央记账人的情况下,许多节点怎样对交易顺序和账本状态达成一致。
只不过,不同公链实现这件事的方法,并不一样。
像 Bitcoin 最经典的是 PoW,也就是工作量证明——矿工依靠算力竞争出块,当网络短时间出现两条合法分支时,节点按照累计工作量选择其中一条继续构建。
所以 Bitcoin 并不存在一个明确的「67% 投票后这个区块永远 Finalized」时刻,它更接近一种概率最终性,后续区块越多,想重新组织掉前面的交易,就需要付出越来越高的算力成本。
这也是为什么大家过去常说,一笔 Bitcoin 交易最好等待 6 个区块确认,毕竟即使算力再高,也不能简单绕过节点正在执行的共识规则。
当然,这并不意味着 Bitcoin 的状态在任何情况下都「绝对无法修改」。理论上,如果整个生态接受一套新的客户端和新的共识规则,通过 Hard Fork,同样可以让过去规则下无效的状态变化变成有效。
但问题就在这里,谁有能力让足够多矿工、Full Node、交易平台、钱包和用户一起接受这样一套新规则?
几乎没有。
开发团队并不能替整个 Bitcoin 网络决定共识规则,矿工、交易平台也很难,因为它需要跨越的共识门槛非常高,当初币安被盗 7000 枚 BTC,就有人建议 CZ 联系大矿工操作,最终不了了之。
以太坊则提供了另一个很经典的样本。
在转向 PoS 之后,现在的以太坊使用 Casper FFG 与 LMD-GHOST 共同组成的 Gasper 共识。简单理解,一部分机制负责判断「当前应该跟哪条链」,另一部分则负责让区块获得真正意义上的 Finality。
当代表至少三分之二质押 ETH 的验证者对相应 checkpoint 达成一致,区块才能进一步走向最终确定;反过来,如果超过三分之一的 stake 长时间不参与正确投票,网络就可能暂时无法形成 Finality,不过 Ethereum 还设计了 inactivity leak,在长时间无法 finalizing 时逐步降低离线验证者的有效权重,让网络最终有机会重新恢复 Finality。
想真正改变这种结果,同样需要改变协议规则和客户端。
正如 2016 年 The DAO 事件,以太坊社区最终通过 Hard Fork,在区块 1,920,000 执行了一次 Ethereum Foundation 当时直接称为 irregular state change 的特殊状态修改,把相关 ETH 转入恢复合约。
只是,拒绝升级、继续维护原有状态的一部分矿工和社区最终形成了 Ethereum Classic(ETC),导致了众所周知的 ETH 与 ETC 分叉,表明不是所有人都接受这套规则。

Cosmos Hub 又有所不同,它使用 CometBFT,更接近典型的 BFT 共识。
可以把它理解为更加典型的 BFT 共识,也即一个区块想真正提交,需要获得超过三分之二 voting power 的 Commit。
它的好处是 Finality 非常明确,一旦区块经过足够验证权投票提交,就不需要像 PoW 那样继续等待越来越多区块,用概率换取安全感。
但它的另一面也非常直接,那就是如果三分之一或以上 voting power 不再提供形成 Commit 所需要的投票,剩余验证人再努力,也凑不出超过三分之二。
这时候网络最安全的选择,就正如本次的「暂停出块」,所以从分布式系统的角度看,这次 Cosmos Hub 的短暂停摆其实并不神秘。
一言以蔽之,一群掌握足够 voting power 的验证人停止参与之后,共识协议按照自己的规则,宁愿失去可用性,也不继续在缺乏足够共识的情况下确认新区块。
这背后其实对应了分布式系统里两个经常被普通用户混在一起的概念:
- Safety:不能让不同节点同时确认两个彼此冲突的最终状态;
- Liveness:网络还能不能持续向前运行、处理新的交易;
对于 BFT 系统来说,当参与共识的节点不足时,暂停有时候恰恰是维护 Safety 所付出的代价,说得直白一点,这本去中心化账本宁愿先停在那里,也不能让剩下的人各记各的。
从这个角度再回头看,会发现公链历史上许多看似完全不同的事故,其实都围绕同一件事展开:
当分布式节点无法继续对「正确状态」形成一致意见时,网络该怎么办?
三、从 Bitcoin 到 Solana,公链真正的风险边界在哪里?
这不是 Cosmos 第一次把这个问题摆到台面上。
早在 2013 年,Bitcoin 就发生过一次非常经典的链分叉事故。

相关阅读
Bitcoin下一步走势:以下是需要关注的重点
哈希视野翻译整理 · 2小时前
Kamino将为CCIP跨链资产提供更高借贷上限与LTV
PANews · 2小时前
COMP上涨27%,跑赢Bitcoin和Ether
哈希视野翻译整理 · 2小时前
JPMorgan称比特币表现可能超越多数资产,但该行仍不会推荐它
哈希视野翻译整理 · 2小时前
ether.fi 12家节点运营商改为强制采用mump2p,Optimum软件上线以太坊主网
Odaily 星球日报 快讯 · 2小时前
持仓价值达11.3亿美元,Vanguard旗下Mid-Cap Index Fund增持Strategy 63.9万股
Odaily 星球日报 快讯 · 2小时前
以上内容不构成投资建议。
本文为来源作者的观点,不代表哈希视野(HASHVUE)的立场,不承担法律责任,图片如有侵权,请联系作者删除。